
画像を抽出
この記事の内容
PDFファイルから画像を抽出します。
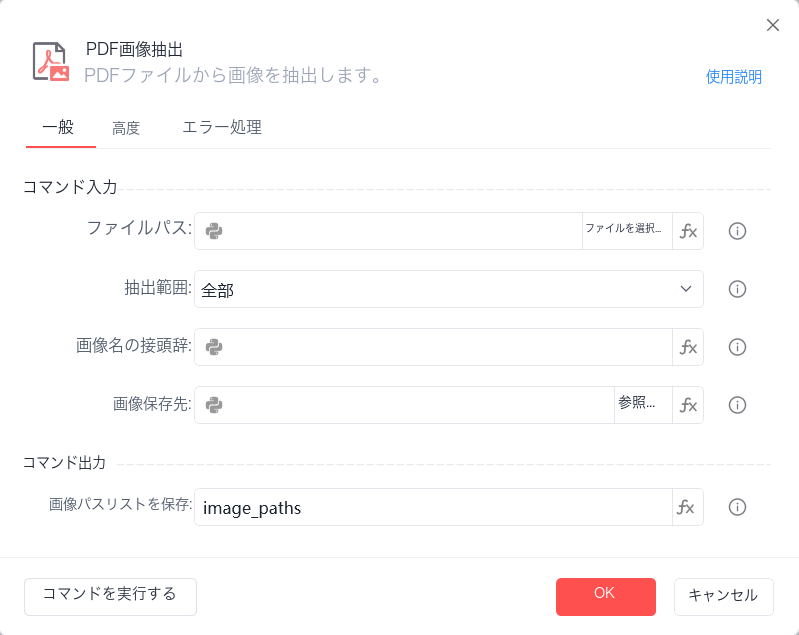
ファイルパス
対象のPDFファイルのパスを、ドライブ文字から入力または選択します。例:"C:\テスト.pdf"
抽出範囲
- すべて:PDFファイル全体からすべての画像を抽出します。
- 単ページ:PDFファイルの指定したページから画像を抽出します。
- 部分:PDFファイルの一部のページから画像を抽出します。開始ページ番号と終了ページ番号を設定する必要があります。
画像名の接頭辞
出力する画像名の接頭辞を設定します。
画像の保存先
出力する画像を保存するローカルディレクトリを入力または選択します。
画像パスリストの保存先
抽出した画像のローカルパスのリストを変数として保存します。
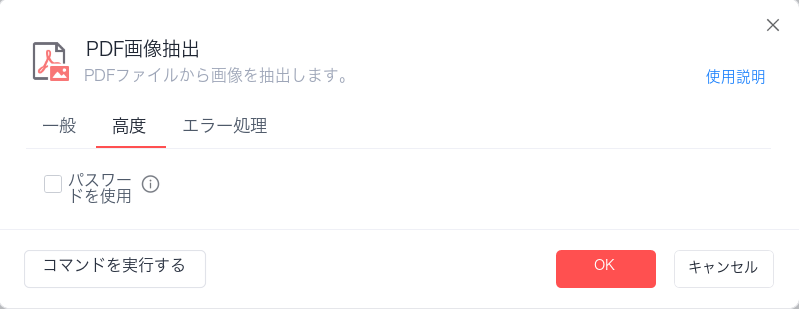
パスワードを使用
ファイルを開くためにパスワードの入力が必要かどうかを指定します。
使用例

このフローの実行ロジック:【画像を抽出】コマンドを使用して、指定したPDFファイルからすべての画像を抽出し、接頭辞を設定してローカルディレクトリに保存します。 --> 【実行ログを出力】コマンドを実行してローカルの画像パスリストを出力します。