
テキストを抽出
この記事の内容
PDFファイルからテキストを抽出します。
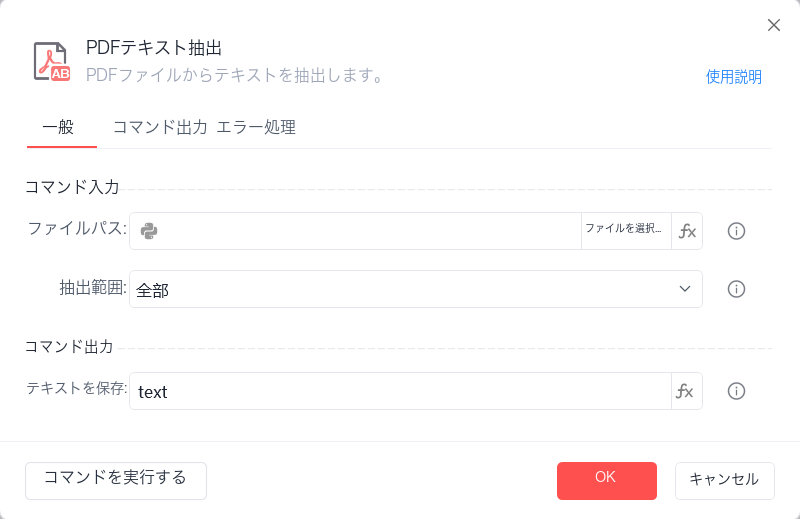
ファイルパス
対象のPDFファイルのパスを、ドライブ文字から入力または選択します。例:"C:\テスト.pdf"
抽出範囲
- すべて:PDFファイル全体からすべてのテキストを抽出します。
- 単ページ:PDFファイルの指定したページからテキストを抽出します。
- 部分:PDFファイルの一部のページからテキストを抽出します。開始ページ番号と終了ページ番号を設定する必要があります。
テキストの保存先
抽出したテキスト内容を変数として保存します。
パスワードを使用
ファイルを開くためにパスワードの入力が必要かどうかを指定します。
使用例
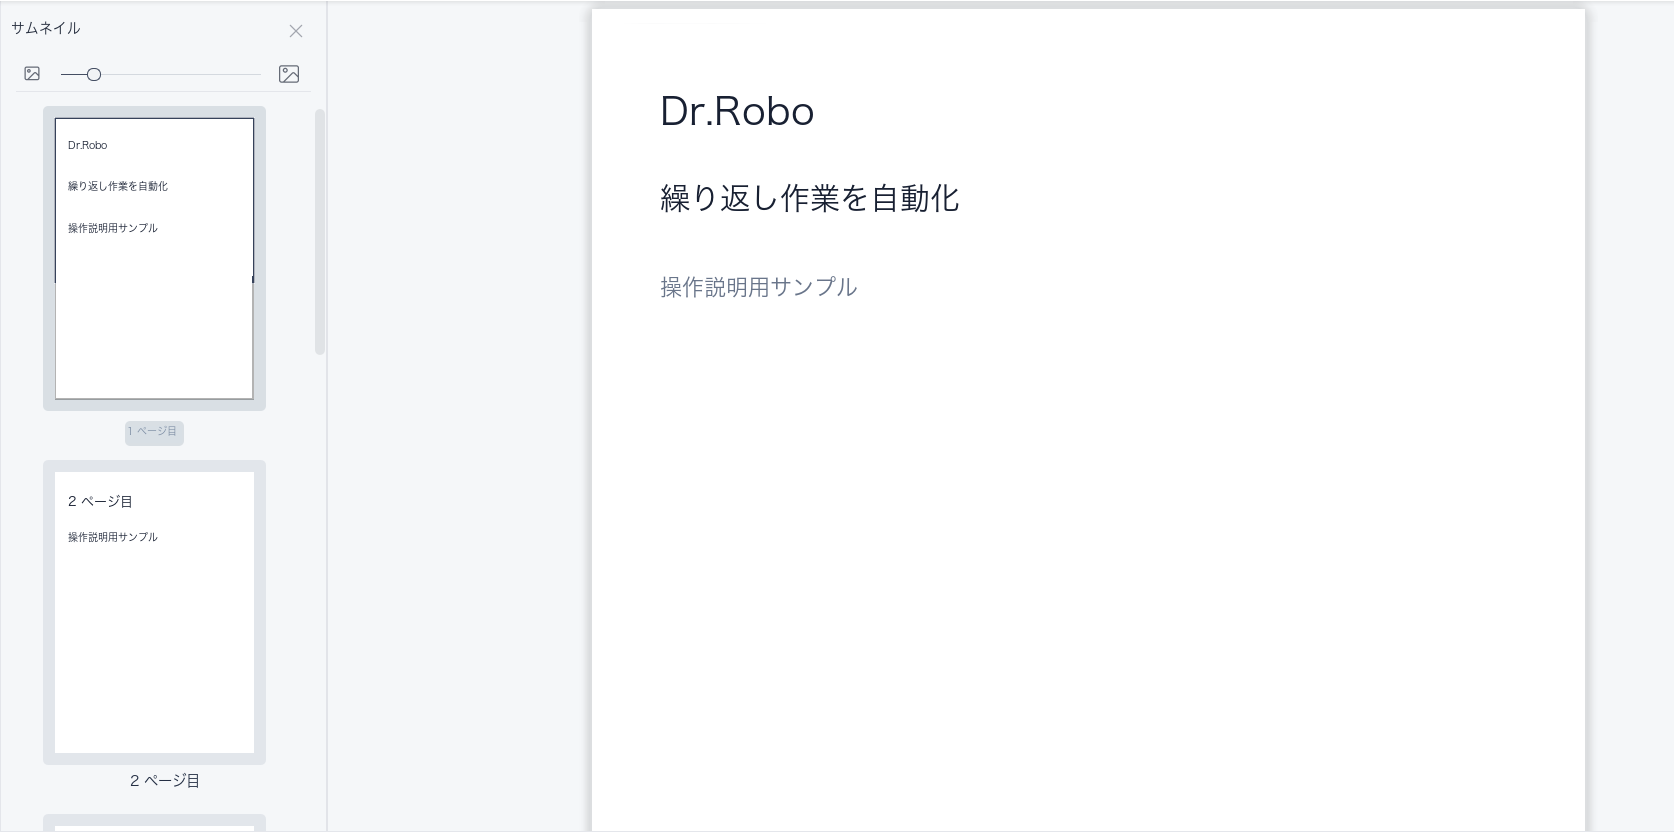
操作説明用に作成した日本語のPDFサンプルと、そのテキスト抽出結果を示す編集例です。
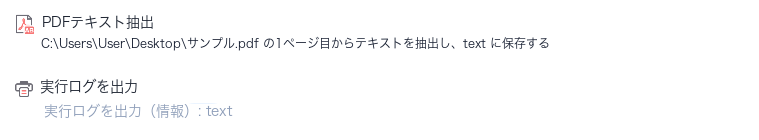
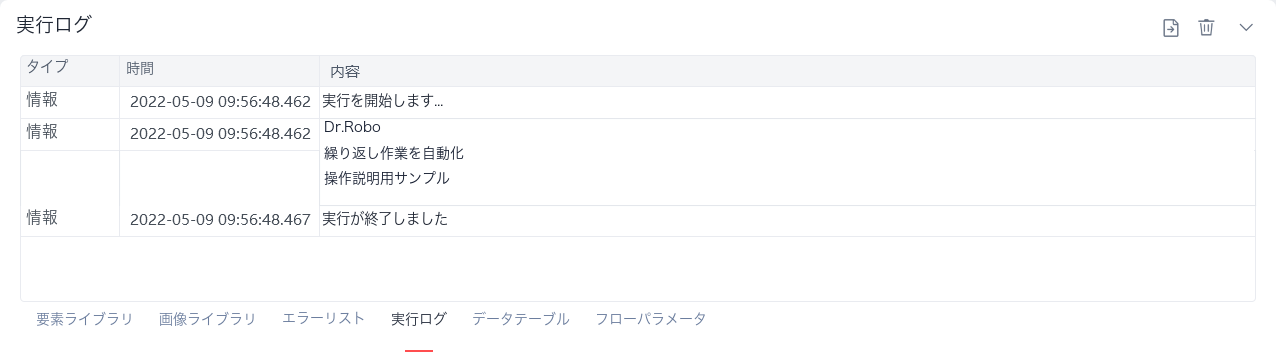
操作説明用に作成した日本語のPDFサンプルと、そのテキスト抽出結果を示す編集例です。
このフローの実行ロジック:【テキストを抽出】コマンドを使用して、指定したPDFファイルの1ページ目からテキストを抽出し、結果を保存します。 --> 【実行ログを出力】コマンドを実行して結果を出力します。