
要素情報を取得(Web)
この記事の内容
Webページ内の要素のテキスト内容、ソースコード、属性値などの情報を取得します。
操作
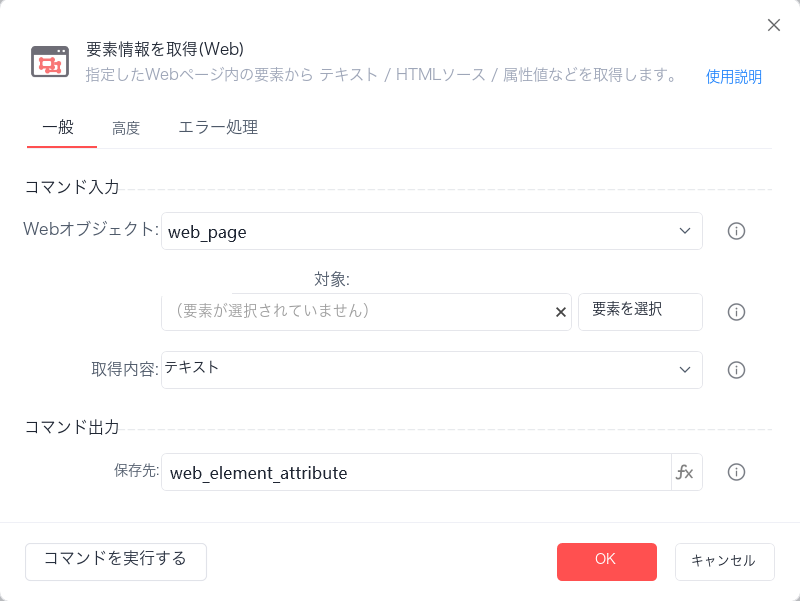
Webオブジェクト
【Webページを開く】または【アクティブなブラウザを取得】コマンドで事前に作成したWebオブジェクトを選択します。
操作対象
「要素ライブラリ」からキャプチャ済みの要素を選択するか、「新しい要素をキャプチャ」で新しいWeb要素をキャプチャし、操作対象にします。
操作
要素のテキスト内容を取得:表示されているテキスト内容を取得します。
要素のソースコードを取得:要素に対応するWebページのソースコードを取得します。
要素の値を取得:数値を取得します。
リンク先URL(href):ハイパーリンク要素や画像要素などのリンク先URLを取得します。
- URLのプレフィックス(http:// または https://)を自動認識して補完:リンク先URLを取得できない場合や、URLのプレフィックスを補完する必要がある場合は、このオプションにチェックを入れます。
要素の属性を取得:href(移動先リンク)、src(画像リンク)、class(クラス)などの属性を取得できます。
要素位置を取得:
要素情報の保存先
取得した操作結果を変数として保存します。
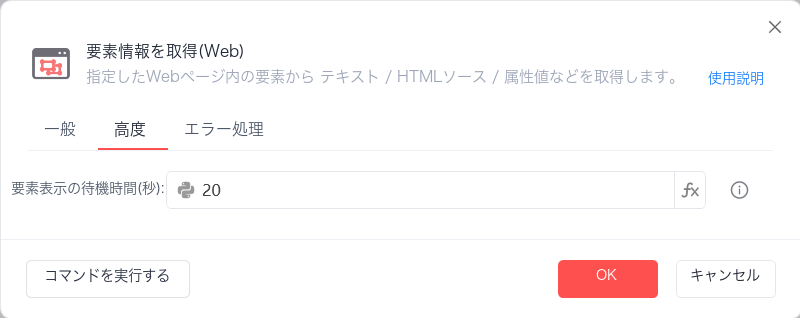
要素の存在を待機(s)
対象要素が存在するまで待機する際のタイムアウト時間です。
使用例
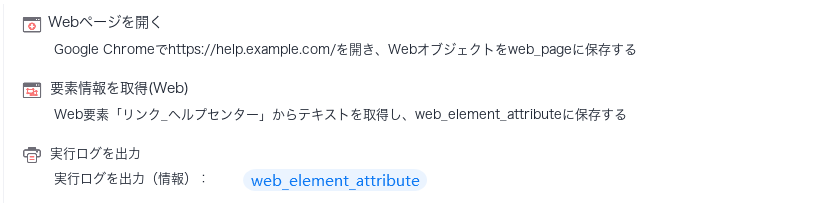
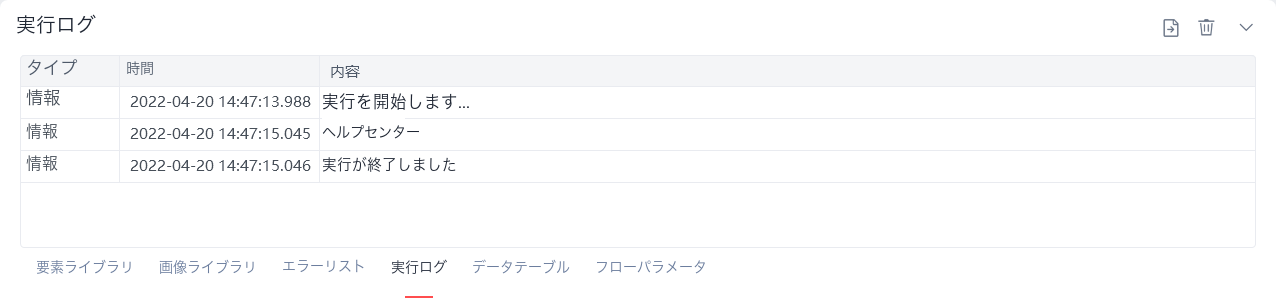
このフローの実行ロジック:Dr.RoboヘルプセンターのWebページを開きます --> 【要素情報を取得(Web)】コマンドで指定要素のテキスト内容を取得し、操作結果を保存します --> 【実行ログを出力】コマンドで操作結果を出力します。